“The real justification of these definitions, however, will reside in their implications.”
——Claude E. Shannon
一个数学 Agent 经历长篇推理才得到正确答案,一个 Coding Agent 经过多次检索、修改和测试才修好程序。最终的成功可以被验证,但沿途的每一步乃至每个 Token,究竟应该获得多少 Credit?
这是强化学习中的 Credit Assignment 问题。对于长程 Agent,它直接关系到模型如何从一个最终结果中学习成千上万次决策。给 Credit 一个明确的数学刻画,能否帮助我们理解现有算法,并进一步改进训练?
导读
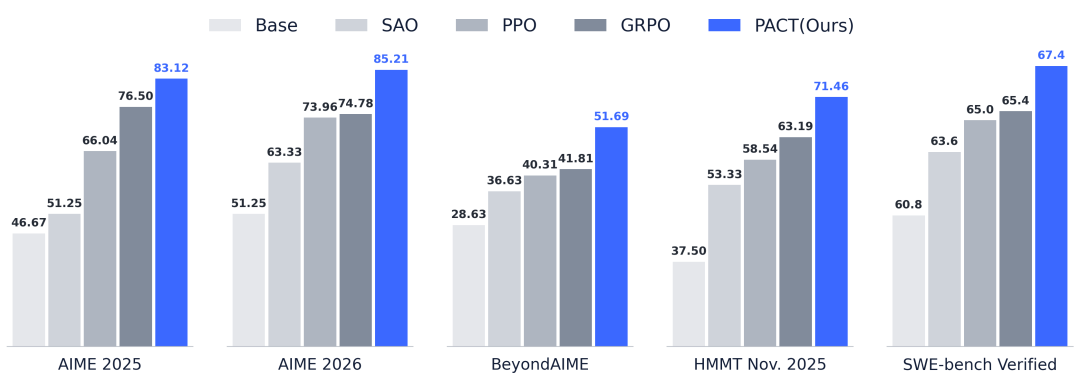
小红书 AllSpark 团队提出三个正则条件,证明满足这些条件的信用分配存在且唯一,并据此分析 OPD、RLOO 和 GAE 中的训练现象。在此基础上,团队提出 PACT,改进 Critic 的回归与策略对齐。在 SWE-bench Verified 上,PACT 达到 67.4% Pass Rate,较 GRPO 提高 2.0 个百分点;在四个数学推理基准上,平均准确率达到 72.87%,较 GRPO 提高 8.80 个百分点。
01、有了最终奖励,还缺什么?
在许多大模型强化学习任务中,奖励只在轨迹结束时给出。答案对不对,测试过没过,这些结果比较明确。但同一个最终奖励背后,可能包含正确的中间推理、无效的探索,也可能包含一次关键的纠错。
不同训练方法处理这个问题的方式并不相同。RLOO、GRPO 等方法构造组级基线,并将得到的优势用于每个 Token 的更新;OPD 则利用教师与学生的分布差异,为每个 Token 提供更细粒度的信号。
这些量都能驱动模型更新,但它们与 Credit 本身是什么关系?OPD 里的教师与 Critic 之间又是否存在联系?
讨论这些问题,需要先明确 Credit 指什么。本文从它应满足的条件出发,确定后续分析所使用的数学对象。对于需要多轮推理和工具调用的 Agent,这也关系到一个实际的训练选择:如何利用最终成败,学习中间的决策。
02、三个条件,唯一确定信用分配
团队提出三个正则条件,对 Credit Assignment 作出约束。
- 完整性。 所有 Credit 相加,应完整解释最终奖励相对于初始预期的偏差。
- 前缀一致性。 对同一个已经生成的前缀,累计 Credit 应保持一致,不能因为后续轨迹的不同而被重新改写。
- 中立性。 在下一步尚未发生时,基于当前已有的信息,下一个 Token 的 Credit 条件期望应为零。
论文证明,满足这三个条件的 Credit 存在且唯一,可以写成下面的形式。
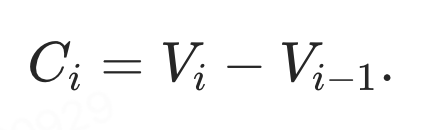
这里,𝑉 表示给定当前历史时对最终奖励的条件期望。每一步的 Credit,就是这一步及其关联的环境反馈揭示后,预期最终奖励发生的变化。
例如,在修复代码时,一次修改及其测试反馈,可能让模型对最终成功的预期上升,也可能让预期下降。这里的 Credit 对应这种预期的变化,而不是把最后一次测试的成败直接复制给此前的每个动作。条件期望还取决于后续使用的策略,因此同一段历史下的 Value 也会随策略变化。
类似于熵的公理化刻画,这里的问题是哪些条件能够唯一确定所研究的对象。前人曾在特定设置下得到类似形式;本文证明,在这三个条件下,Credit 被唯一确定,后续可以围绕这一对象研究估计方法。
03、一个表示,连接三种训练现象
OPD 的教师与 Critic 有什么关系?
OPD 通过教师与学生之间的 KL 目标训练模型,通常不需要一个显式的 Value Head。它与依赖 Critic 的强化学习之间,存在怎样的联系?
论文考虑一个兼顾奖励提升与偏离学生策略代价的理想教师,并证明,在这一假设下,OPD 的期望策略梯度与唯一 Credit 表示诱导的策略梯度成比例。因此,教师可以被理解为一个隐式 Critic。
RLOO 的响应级优势为什么仍然有效?
RLOO 用同一 Prompt 下其他响应的平均奖励作为基线,将当前响应的奖励减去这一基线,得到用于各个 Token 更新的响应级优势。这个优势本身不是 Token-Level Credit,但它产生的期望梯度贡献与使用唯一 Credit 时相同。两者仍可能有不同的采样噪声,因此,梯度等价并不意味着统计效率相同。
为什么更细粒度的 GAE 会对 Critic 误差敏感?
论文证明,对任意固定幅度,有界奖励下超过该幅度的 Credit 的期望数量有一个不随最大轨迹长度增长的上界,这就是近似 Credit 稀疏性。当局部 Credit 较小时,GAE 中保留的中间 Critic 误差可能干扰优势估计。取 λ=1 可以消除这些中间误差项,这也是 PACT 的选择。
04、PACT 让 Critic 更好地回归 Value,并跟上 Actor
Credit 与 Value 的变化紧密相关。接下来的问题是,如何让 Critic 更准确地回归 Value,并跟上正在更新的策略?
PACT 的全称是 Policy Aligned Critic Training,分别调整 Value 的回归目标与 Actor、Critic 的更新流程。
用 BCE 回归有界 Value
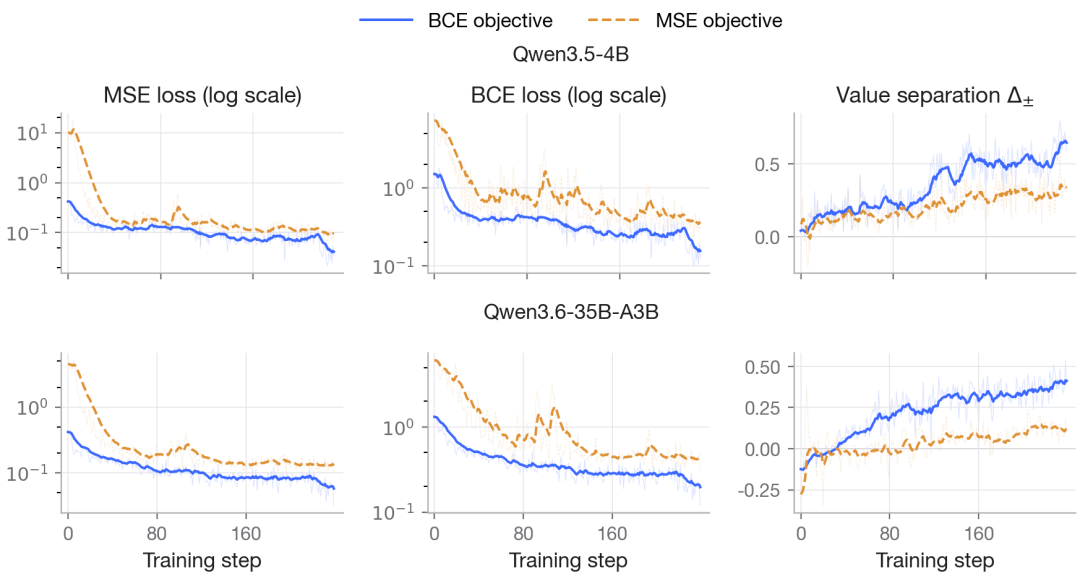
对于有界最终奖励,可以通过正仿射变换将其归一化到 [0,1],而不改变最优策略。PACT 用二元交叉熵(BCE)替代均方误差(MSE)来回归 Value。在这一设置下,两者的最优预测都是奖励的条件期望。在固定策略的对照实验中,BCE Critic 在两种模型规模上都收敛更快、回归误差更低,也能更清楚地区分成功与失败轨迹的 Value。
Actor 先更新,使 Critic 修正能够面向新策略
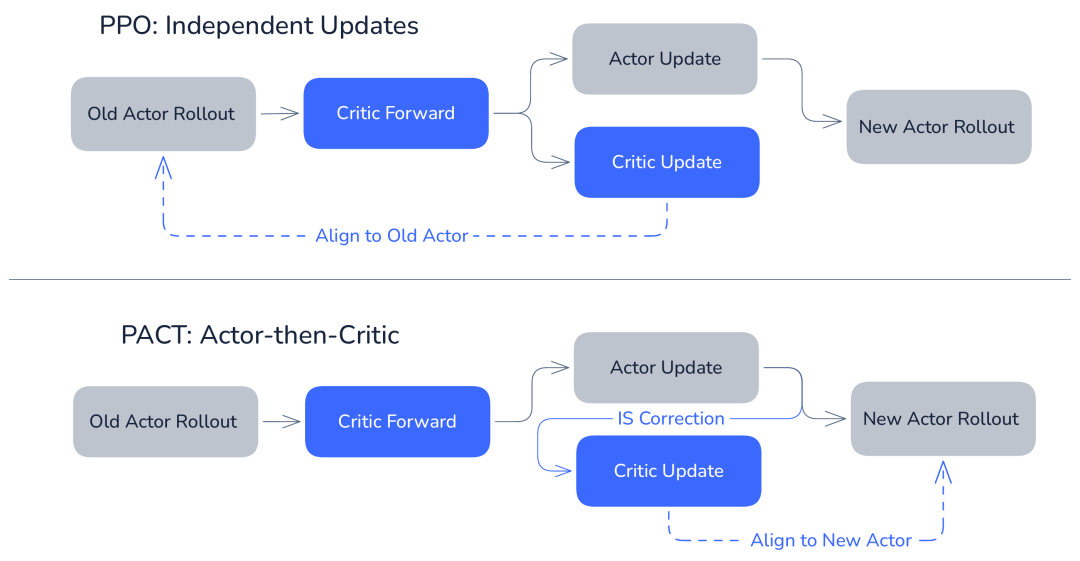
Actor 更新后,同一个前缀下后续生成的分布会发生变化,对应的 Value 也可能改变。在本文研究的 PPO 训练流程中,Actor 和 Critic 都使用旧策略采集的轨迹。Actor 完成更新时,Critic 并没有随之对齐新策略。
PACT 采用 Actor-Then-Critic 的顺序,先更新 Actor,再利用新策略的概率对 Critic 训练进行重要性采样修正,使其更好地对齐更新后的策略。整个过程复用已有轨迹,只需额外进行一次更新后 Actor 的前向计算。实际实现使用局部重要性比率,并屏蔽范围外的样本。
05、代码与数学任务,PACT 表现如何?
在代码任务中,团队使用 Qwen3.6-35B-A3B,在 OpenSWE 上训练。PACT 在 SWE-bench Verified 上达到67.4% Pass Rate,相比 GRPO、PPO 和 SAO,分别提高2.0、2.4 和 3.8 个百分点。
在 Qwen3.5-4B上,团队使用 OpenCode 在 DAPO-Math-17k 的 3,200 道题目子集上训练。PACT 在 AIME 2025、AIME 2026、BeyondAIME 和 HMMT November 2025 四个基准上均优于所比较的方法,Avg@16 平均准确率达到72.87%,较 GRPO 和 PPO(λ=1)分别提高8.80 和 13.16 个百分点。
团队还比较了有无 Critic 重要性采样修正的结果。保持更新顺序、BCE 目标和 Actor 侧设置不变,仅移除 Critic IS,数学平均准确率从 72.87% 降至 67.74%。加入修正后,平均提高 5.13 个百分点,四个基准均有提升。
对长程 Agent 的训练,这项工作给出了一个可供分析和估计的 Credit 对象。它解释了教师如何承担隐式 Critic 的作用、响应级优势为何能产生相同的期望梯度,以及中间 Value 误差如何进入 GAE。PACT 则据此调整 Critic 的回归与更新流程,并在数学和代码任务上检验了效果。
开头香农所说的“implications”,在这里对应理论刻画之后的算法分析和实验。信用分配被确定下来后,训练方法就有了明确的估计对象,也可以进一步研究怎样减少估计误差、让 Critic 跟上策略的变化。
论文题目 PACT:
From Credit Assignment to Critic Alignment
论文链接:
https://arxiv.org/abs/2609.26355
代码链接:
https://github.com/AllSpark-Research/PACT
作者简介
- 傅嘉言,AllSpark Pevek 组算法实习生,北京大学数学科学学院在读硕士研究生。
- 沐川,AllSpark Pevek 组负责人。
文章来自:51CTO
